Reusable AI Backend Architecture
Implementado · registro histórico Clean ArchitectureArquitetura modular e reutilizável para aplicações de IA, desenvolvida com Python, FastAPI e PostgreSQL, integrando segurança defensiva, resiliência, observabilidade e testes automatizados.
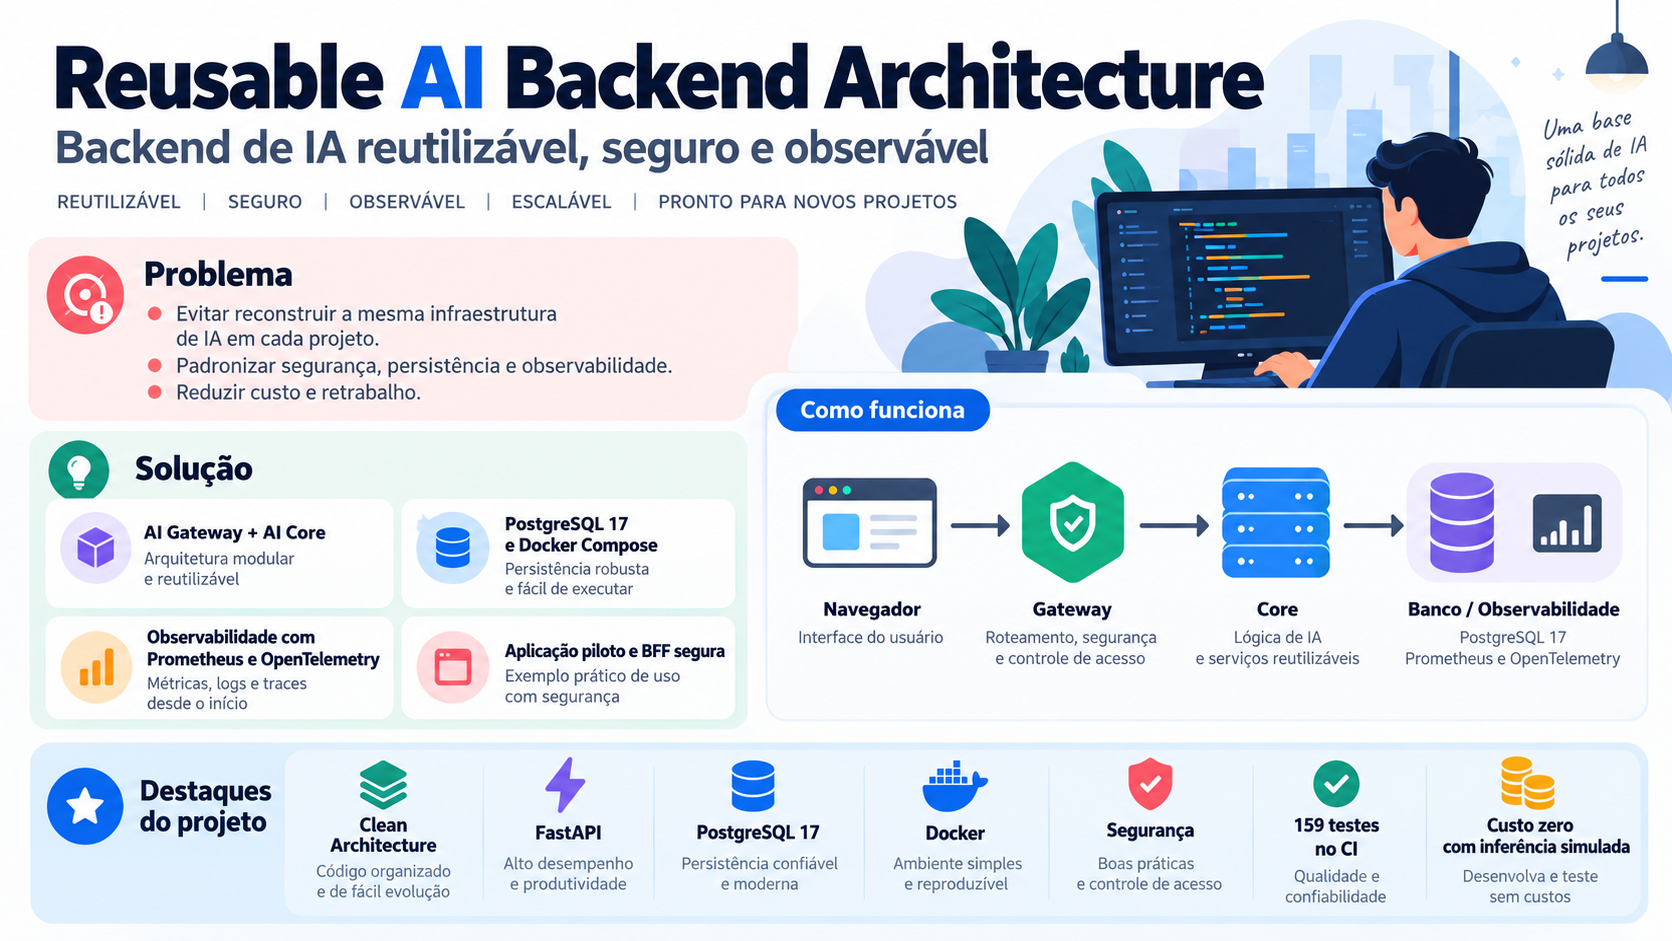
Visão Geral: Problema e Solução de Engenharia
Ao incorporar Inteligência Artificial Generativa em produtos corporativos, a maioria dos times concentra-se exclusivamente em engenharia de prompts e seleção de modelos. No entanto, em cenários de produção, as falhas mais críticas derivam da ausência de engenharia de software defensiva no backend.
- Acoplamento Proprietário (Vendor Lock-in): Código de negócio atrelado a SDKs específicos, inviabilizando contingência entre provedores em caso de queda externa.
- Estouro Orçamentário (Condição de Corrida TOCTOU): Validação de cotas após a execução (post-billing), permitindo que rajadas assíncronas concorrentes estourem o limite financeiro.
- Falhas em Cascata: Falta de disjuntores (Circuit Breakers) e retentativas inteligentes, fazendo instabilidades de terceiros derrubarem o serviço central.
- Falhas Graves de Borda: Exposição de chaves mestras de API no navegador, ausência de proteção CSRF e vulnerabilidades de acesso indevido a dados de outros locatários (IDOR).
Uma arquitetura de referência em Monólito Modular baseada em Clean Architecture, Arquitetura Hexagonal (Ports & Adapters) e princípios SOLID. Separa rigorosamente o domínio de negócio da infraestrutura HTTP, protege cotas financeiras com protocolo de reserva atômica em duas fases, persiste dados no PostgreSQL 17 com isolamento estrito anti-IDOR e oferece observabilidade integrada com Prometheus e OpenTelemetry.
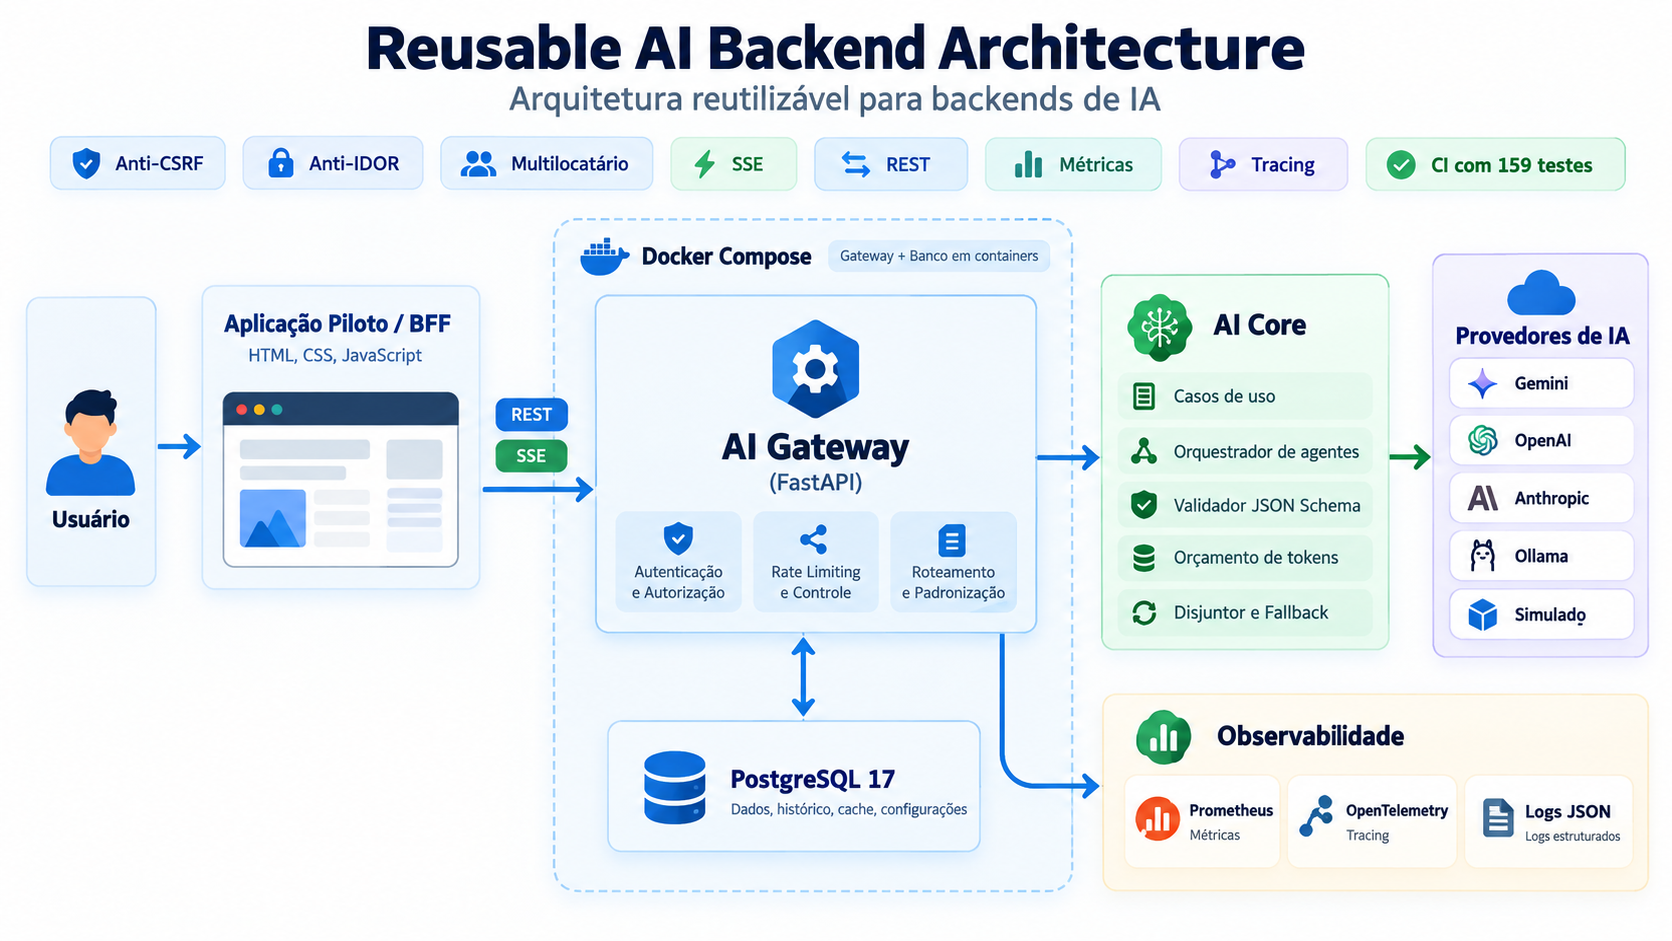
Diagrama de Arquitetura Técnica
A topologia do sistema estrutura a separação física e lógica entre clientes externos, camada de borda intermediária (BFF), gateway HTTP com defesas ativas, núcleo de domínio puro (AI Core), adaptadores de modelo e banco relacional:
Decisões Técnicas e Pilares Arquiteturais
AI Core Desacoplado
Biblioteca Python pura (packages/ai-core). Zero importações de frameworks web (fastapi, starlette) ou bibliotecas HTTP. Comunicação feita exclusivamente através de contratos abstratos (Ports).
AI Gateway FastAPI
Serviço de alta performance sobre Uvicorn/ASGI (services/ai-gateway). Endpoints canônicos versionados (/v1/chat/...), streaming Server-Sent Events (SSE) e autorreparo de JSON Schema.
Reserva Atômica em Duas Fases
A cota de tokens é retida previamente antes da chamada ao modelo e liquidada com o consumo real no encerramento, mitigando condições de corrida TOCTOU intraprocesso via travas assíncronas (asyncio.Lock).
Circuit Breaker & Fallback
Disjuntor com estados Closed, Open e Half-Open, retentativas com backoff exponencial e jitter estocástico (anti-thundering herd) e roteador de contingência automática entre modelos.
Persistência Relacional Segura no PostgreSQL 17
Diferente de protótipos que mantêm histórico apenas em memória volátil, o projeto adota persistência durável em PostgreSQL 17 Alpine via driver assíncrono asyncpg:
- Pool Assíncrono de Conexões: Alta eficiência de I/O não-bloqueante dimensionada para concorrência de inferência.
- Migrações Idempotentes e Versionadas: Esquema gerenciado diretamente no banco através da tabela de controle
schema_migracoes. - Barramento Relacional Anti-IDOR: Toda consulta impõe verificação estrita de posse pelo usuário proprietário da conversa:
SELECT id_conversa, titulo, criado_em FROM conversas
WHERE id_conversa = $1 AND id_usuario = $2; - Persistência Alternativa em SQLite WAL: Adaptador local com Write-Ahead Logging para execução ágil em CLI ou testes isolados.
Adaptadores de Provedores de IA
O sistema satisfaz a porta PortaProvedorLLM com múltiplos adaptadores desacoplados, permitindo alternância transparente de provedor sem alterar uma linha de código do domínio:
- AdaptadorSimulado: Emula respostas imediatas e consumo determinístico de tokens, viabilizando desenvolvimento local e esteira de CI sem custo financeiro com APIs pagas.
- AdaptadorOllama: Inferência com modelos abertos (Llama, Mistral). Quando o Ollama e o modelo são executados localmente, as requisições de inferência não precisam ser enviadas a um provedor externo. Privacidade também depende da configuração, dos logs e do ambiente.
-
Provedores de Nuvem Comercial (OpenAI, Gemini, Anthropic, DeepSeek):
Código de transporte estruturado e validado em testes unitários com
MockTransport(HTTPX). Em produção real, ativados mediante fornecimento de chaves de API no ambiente.
Segurança Defensiva, Proteção de Borda e Camada BFF
A segurança não foi tratada como um adendo final, mas como requisito fundacional da arquitetura:
- Barramento Anti-Spoofing: Descarte imediato e registro de auditoria de qualquer injeção indevida do cabeçalho
X-User-IDpor clientes externos. - Camada Intermediária BFF: Roteador dedicado que isola o navegador, gerencia sessões com cookies assinados via HMAC-SHA256 (
piloto_sessao) com flagsHttpOnly,SameSite=LaxeSecure. - Proteção Anti-CSRF: Tokens anti-CSRF validados em tempo constante através de
hmac.compare_digestpara mitigar ataques de temporização. - Cabeçalhos HTTP Hardened: Políticas estritas de segurança injetadas por middleware:
HSTS(RFC 6797),X-Content-Type-Options: nosniff,X-Frame-Options: DENY,Referrer-PolicyePermissions-Policy.
Observabilidade Contínua: Métricas e Traces
Telemetria com métricas de baixa cardinalidade para acompanhar o comportamento da aplicação. O impacto em desempenho depende da configuração e da carga e deve ser medido no ambiente de execução:
- Prometheus (/metrics): Contadores de requisições, taxas de erro HTTP, latências de inferência em milissegundos, consumo acumulado de tokens e contadores de tentativas de violação de segurança (ex: IDOR barrado).
- OpenTelemetry Distribuído: Emissão de spans padronizados propagando o cabeçalho W3C
traceparente identificador únicoX-Request-IDentre camadas. - Privacidade por Projeto: Descarte estrito de dados pessoais (PII) e conteúdo de prompts dos atributos de telemetria.
Aplicação Piloto Demonstrativa
A aplicação servida em http://localhost:8000/piloto é uma interface SPA leve construída com tecnologias web padrão (HTML5, CSS3, Vanilla JS) sem ecossistema Node.js/npm. Ela é meramente uma interface demonstrativa e não o produto principal. Sua finalidade é comprovar visualmente o streaming SSE de inferência, telemetria em tempo real, persistência relacional e a alternância controlada entre perfis de teste (usuario_alfa e usuario_beta) para demonstrar o isolamento multilocatário na prática.
Transparência Técnica e Limitações Arquiteturais
Seguindo os mais altos padrões de transparência técnica sênior, destacam-se as premissas e os limites operacionais da implementação atual:
-
1. Escopo Intraprocesso do Orçamento:
As travas assíncronas do orçamento de tokens e limitador de taxa operam em memória local (
asyncio.Lock). Suas garantias contra condições de corrida TOCTOU aplicam-se ao processo local da aplicação. Para escalabilidade horizontal distribuída (múltiplos nós ou réplicas), um teto orçamentário consolidado requer um coordenador de estado externo (como Redis com scripts transacionais em Lua). -
2. Terminação TLS e Proxies Reversos:
O Gateway avalia a injeção do cabeçalho HSTS inspecionando
request.url.scheme == "https"(RFC 6797 Seção 7.2). Em implantações de produção atrás de balanceadores/proxies (Cloudflare, AWS ALB, Nginx), o servidor Uvicorn deve ser configurado com--proxy-headerse--forwarded-allow-ips. - 3. Escopo dos Testes e Auditoria: A documentação consultada registra 159 testes com PostgreSQL em CI. Esse é um registro histórico, sem execução atual da suíte nesta reformulação. Testes automatizados não constituem certificação externa de segurança nem substituem testes de invasão em ambiente dedicado.